
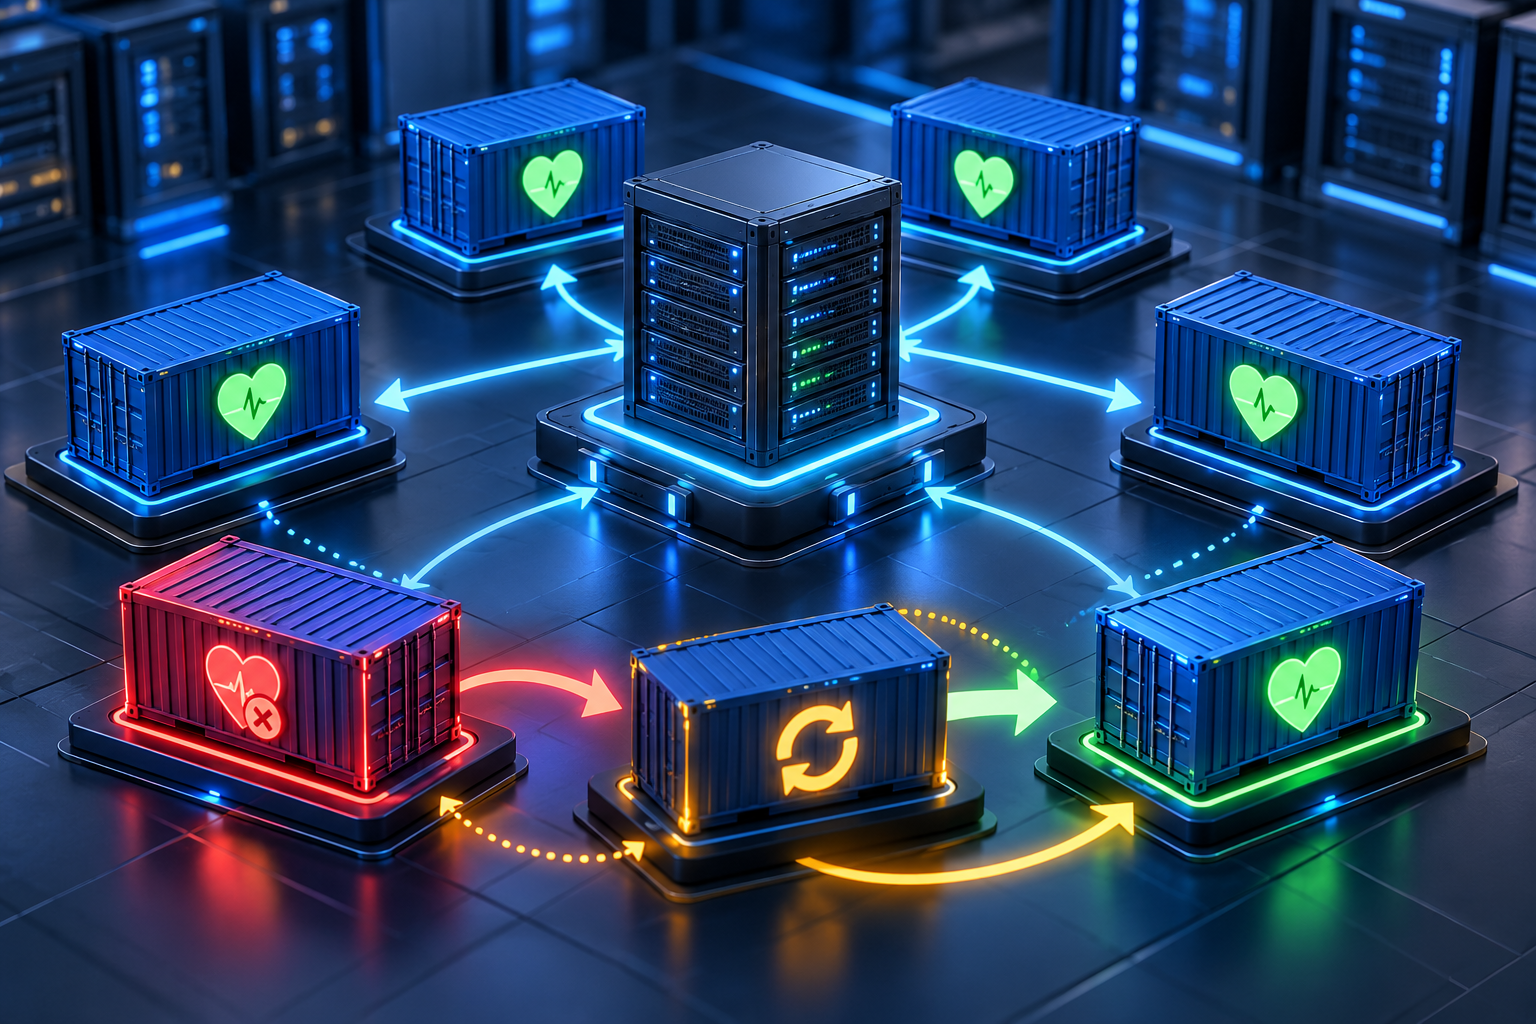
Container còn chạy không có nghĩa ứng dụng bên trong vẫn khỏe. Docker `HEALTHCHECK` cho phép kiểm tra trạng thái service từ bên trong container, còn restart policy quyết định khi nào Docker tự khởi động lại container sau khi process thoát. Bài viết này hướng dẫn cách kết hợp healthcheck, `depends_on: condition: service_healthy`, restart policy và kiểm tra trạng thái bằng `docker inspect`, đồng thời giải thích giới hạn quan trọng: container `unhealthy` không tự được restart chỉ vì healthcheck fail trong Docker Engine thông thường.
Một container có trạng thái Up nhưng ứng dụng bên trong vẫn có thể không phục vụ được request. Ví dụ process chính còn sống nhưng web server bị deadlock, database chưa sẵn sàng hoặc dependency phía sau lỗi.
Docker giải quyết một phần bài toán này bằng healthcheck. Healthcheck chạy một lệnh định kỳ trong container và gán trạng thái:
starting;healthy;unhealthy.
Tuy nhiên, cần phân biệt rõ: restart policy chỉ tự restart khi container process kết thúc theo điều kiện policy; Docker Engine không tự restart container chỉ vì healthcheck chuyển sang unhealthy. Đây là điểm nhiều người hiểu sai.
Nếu bạn mới triển khai Docker trên VPS, xem trước bài Cài Docker và Docker Compose trên VPS Ubuntu. Nếu muốn tránh một container chiếm hết CPU/RAM, xem thêm Giới hạn CPU và RAM cho Docker trên VPS.
Healthcheck kiểm tra gì?
Healthcheck nên xác minh chức năng thật sự quan trọng của service.
Ví dụ với web app:
healthcheck:
  test: ["CMD", "curl", "-f", "http://localhost:3000/health"]
  interval: 30s
  timeout: 5s
  retries: 3
  start_period: 20s
Ý nghĩa:
interval: khoảng cách giữa các lần check;timeout: thời gian tối đa cho một check;retries: số lần fail liên tiếp trước khi thànhunhealthy;start_period: thời gian khởi động ban đầu, fail trong giai đoạn này không bị tính như fail bình thường.
Docker Docs hiện cũng hỗ trợ start_interval trên phiên bản Engine mới hơn để điều chỉnh nhịp check trong thời gian khởi động.
Dockerfile HEALTHCHECK
Bạn có thể định nghĩa ngay trong image:
HEALTHCHECK --interval=30s --timeout=5s --retries=3 \
  CMD curl -f http://localhost:3000/health || exit 1
Ưu điểm là image tự mang logic healthcheck.
Compose có thể override healthcheck của image nếu cần.
Healthcheck bằng Docker Compose
Ví dụ:
services:
  api:
    image: my-api:latest
    restart: unless-stopped
    healthcheck:
      test: ["CMD-SHELL", "curl -fsS http://localhost:3000/health || exit 1"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 20s
Validate:
docker compose config
Khởi động:
docker compose up -d
Theo dõi:
docker compose ps
Xem trạng thái health chi tiết
Dùng:
docker inspect api --format '{{json .State.Health}}'
Hoặc dễ đọc hơn nếu có jq:
docker inspect api | jq '.[0].State.Health'
Output healthcheck gần nhất được lưu trong trạng thái container và rất hữu ích để debug.
Exit code healthcheck
Docker quy ước:
0= healthy;1= unhealthy;2= reserved, không nên dùng.
Vì vậy script healthcheck nên trả đúng exit code.
Ví dụ:
#!/bin/sh
curl -fsS http://127.0.0.1:8080/health >/dev/null || exit 1
exit 0
Healthcheck nên kiểm tra sâu tới đâu?
Một health endpoint tốt thường kiểm tra vừa đủ để biết service có thể phục vụ.
Không nên mỗi 10 giây lại chạy query nặng vào database production.
Có thể tách:
- liveness: process/app còn hoạt động;
- readiness: app đã sẵn sàng nhận traffic;
- dependency check: database/cache có reachable hay không.
Với Docker Compose đơn giản, thường chỉ cần một healthcheck đủ nhẹ để phản ánh readiness chính.
Restart policy là gì?
Compose hỗ trợ:
restart: "no"
restart: always
restart: on-failure
restart: on-failure:3
restart: unless-stopped
no
Không restart tự động.
on-failure
Restart khi process kết thúc với exit code khác 0.
always
Luôn restart khi container dừng, trừ các tình huống quản trị nhất định.
unless-stopped
Tương tự always, nhưng nếu bạn chủ động stop container thì Docker không tự bật lại sau daemon restart.
Trên VPS chạy service dài hạn, unless-stopped thường dễ vận hành.
Healthcheck fail có tự restart không?
Không, không phải trong Docker Engine thông thường.
Healthcheck chỉ đổi trạng thái container sang unhealthy. Restart policy hoạt động dựa trên việc process/container kết thúc.
Nếu bạn muốn tự restart khi unhealthy, có vài hướng:
- ứng dụng tự exit khi không thể phục hồi;
- watchdog bên ngoài theo dõi health status rồi restart;
- dùng orchestrator có cơ chế reconciliation như Docker Swarm/Kubernetes;
- hệ thống monitoring gọi automation có kiểm soát.
Đừng viết cron docker restart vô điều kiện mỗi phút vì có thể tạo restart loop và che nguyên nhân thật.
depends_on và service_healthy
Compose hỗ trợ chờ dependency healthy trước khi start service phụ thuộc.
Ví dụ:
services:
  db:
    image: postgres:18
    environment:
      POSTGRES_DB: app
      POSTGRES_USER: app
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"]
      interval: 10s
      timeout: 5s
      retries: 5
      start_period: 30s

  web:
    image: my-web:latest
    depends_on:
      db:
        condition: service_healthy
    restart: unless-stopped
Điểm quan trọng: short syntax depends_on: [db] chỉ đảm bảo container dependency được start trước; nó không chờ database healthy.
Khi nào healthcheck sai gây hại?
Check quá nặng
Một healthcheck thực hiện query phức tạp có thể tự tạo tải.
Check phụ thuộc Internet ngoài
Nếu app vẫn hoạt động nhưng một API ngoài tạm lỗi, healthcheck có thể đánh dấu container unhealthy không cần thiết.
Timeout quá ngắn
Service bận tạm thời có thể fail check dù vẫn phục vụ được.
Start period quá ngắn
Database hoặc Java app khởi động lâu có thể bị đánh dấu unhealthy sớm.
Ví dụ Nginx healthcheck
Nếu image có curl hoặc wget:
healthcheck:
  test: ["CMD-SHELL", "wget -q --spider http://127.0.0.1/ || exit 1"]
  interval: 30s
  timeout: 5s
  retries: 3
Không phải image nào cũng có curl. Hãy dùng tool thực sự tồn tại trong image hoặc bổ sung script riêng.
Ví dụ PostgreSQL
healthcheck:
  test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"]
  interval: 10s
  timeout: 5s
  retries: 5
  start_period: 30s
pg_isready kiểm tra PostgreSQL có chấp nhận connection hay không, phù hợp hơn việc chỉ kiểm tra port 5432 mở.
Theo dõi health event
Docker tạo event khi health status thay đổi.
Xem realtime:
docker events --filter event=health_status
Hoặc xem toàn bộ event:
docker events
Đây là nguồn tốt để tích hợp automation/alert.
Kết hợp với monitoring
Healthcheck không thay thế monitoring.
Một container có thể healthy nhưng:
- latency tăng cao;
- CPU gần 100%;
- error rate tăng;
- queue backlog;
- disk gần đầy.
Bạn vẫn nên dùng metric monitoring. Xem bài Giám sát VPS bằng Prometheus, Node Exporter và Grafana và Cài Alertmanager cho Prometheus.
Quy trình production nên dùng
- định nghĩa endpoint health nhẹ;
- thêm healthcheck;
- chọn restart policy phù hợp;
- dùng
service_healthycho dependency cần readiness; - theo dõi health event;
- alert khi
unhealthykéo dài; - chỉ tự restart khi hiểu failure mode;
- điều tra nguyên nhân bằng log.
Nếu cần log tập trung, xem bài Thu thập log tập trung bằng Grafana Loki và Alloy.
Sai lầm thường gặp
Nghĩ unhealthy sẽ tự restart
Docker Engine không làm vậy chỉ nhờ healthcheck.
Healthcheck chỉ kiểm tra process
Process sống chưa chắc app phục vụ được request.
Dùng curl nhưng image không có curl
Healthcheck sẽ fail vĩnh viễn dù app khỏe.
Restart loop che mất lỗi
Restart quá nhanh khiến log khó đọc và tăng tải.
Không đặt start period
Service khởi động chậm dễ bị đánh dấu unhealthy oan.
Checklist
- Health endpoint nhẹ và ổn định.
- Healthcheck trả exit code đúng.
- Interval/timeout/retries hợp lý.
- Có
start_periodcho service khởi động chậm. - Chọn restart policy phù hợp.
- Hiểu rằng unhealthy không tự restart.
-
depends_ondùngservice_healthykhi cần. - Theo dõi
docker eventshoặc monitoring. - Có log để điều tra root cause.
FAQ
Docker healthcheck có tự restart container không?
Không. Healthcheck chỉ cập nhật trạng thái health. Restart policy phản ứng với container process kết thúc, không phải chỉ vì health status unhealthy.
restart: always và unless-stopped khác nhau thế nào?
unless-stopped phù hợp khi bạn muốn container giữ trạng thái dừng nếu đã chủ động stop. always có hành vi restart mạnh hơn sau daemon restart.
depends_on có chờ database sẵn sàng không?
Short syntax không chờ healthy. Muốn chờ healthcheck pass, dùng long syntax với condition: service_healthy.
Có nên healthcheck bằng / của website không?
Có thể, nhưng endpoint /health riêng thường tốt hơn vì nhẹ và ổn định hơn.
Healthcheck bao lâu chạy một lần?
Tùy service. 10–30 giây phổ biến với web app, nhưng đừng đặt quá dày nếu check tốn tài nguyên.
Kết luận
Docker healthcheck giúp phân biệt “process còn sống” với “service thực sự khỏe”, còn restart policy xử lý vòng đời khi container thoát. Hai cơ chế bổ trợ nhau nhưng không phải một.
Hãy thiết kế healthcheck nhẹ, dùng service_healthy để kiểm soát dependency và kết hợp monitoring thay vì dựa vào restart tự động như một giải pháp chữa mọi lỗi.
Nếu bạn đang vận hành nhiều container trên một VPS, có thể tham khảo các gói VPS tại HUONG CLOUD và lựa chọn tài nguyên dựa trên tải thực tế sau khi đã đặt resource limit và health monitoring.
Nguồn tham khảo
- Docker Docs — Dockerfile HEALTHCHECK: https://docs.docker.com/reference/dockerfile/#healthcheck
- Docker Docs — Compose services / healthcheck: https://docs.docker.com/reference/compose-file/services/
- Docker Docs — Control startup order in Compose: https://docs.docker.com/compose/how-tos/startup-order/
- Docker Docs — Restart policies: https://docs.docker.com/engine/containers/start-containers-automatically/
Kết luận
Nếu chưa chắc cấu hình hoặc loại dịch vụ nào phù hợp, hãy gửi nhu cầu thực tế để đội ngũ hỗ trợ tư vấn trước khi mua.
Chưa biết nên chọn gói nào?
Xem bảng giá VPS hoặc liên hệ đội ngũ hỗ trợ để chọn cấu hình phù hợp.
Xem bảng giá VPS →