
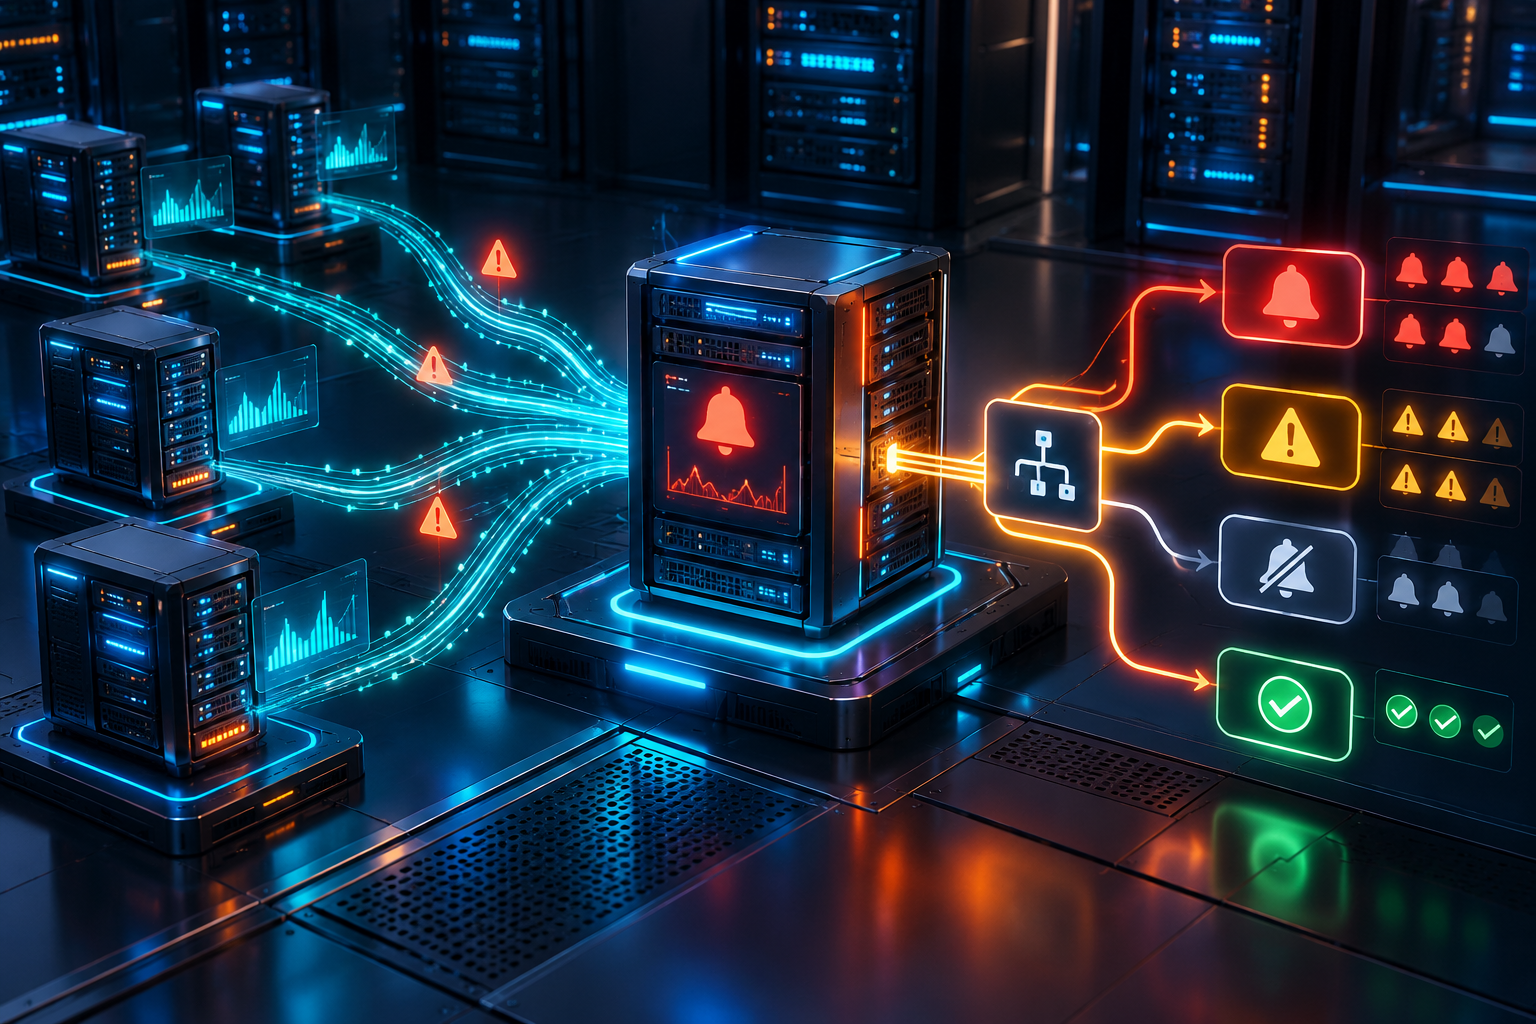
Prometheus có thể phát hiện CPU, RAM, disk hoặc service vượt ngưỡng, nhưng để biến các điều kiện đó thành cảnh báo vận hành hữu ích bạn cần một lớp xử lý riêng. Alertmanager nhận alert từ Prometheus, nhóm các alert liên quan, loại trùng, áp inhibition và route chúng tới đúng receiver. Bài viết này hướng dẫn cài Alertmanager trên Ubuntu, khai báo rule trong Prometheus, kết nối hai thành phần, thiết kế severity, grouping, silence và kiểm tra cấu hình an toàn trước khi sử dụng production.
Prometheus rất tốt ở việc thu thập metric và đánh giá điều kiện cảnh báo, nhưng bản thân Prometheus không nên gánh toàn bộ logic gửi thông báo. Phần việc đó thuộc về Alertmanager.
Alertmanager nhận alert từ Prometheus rồi xử lý các bước như:
- nhóm nhiều alert liên quan thành một notification;
- loại trùng;
- route theo label như
severity,team,service; - tạm im lặng bằng silence;
- dùng inhibition để ẩn alert phụ khi alert gốc đã xảy ra;
- gửi tới email, webhook hoặc receiver khác được hỗ trợ.
Nếu bạn chưa có Prometheus/Node Exporter, nên triển khai trước theo bài Giám sát VPS bằng Prometheus, Node Exporter và Grafana. Bài hiện tại chỉ tập trung vào lớp alerting.
Prometheus và Alertmanager phân chia trách nhiệm thế nào?
Luồng chuẩn có dạng:
Node Exporter / Application metrics
              ↓
          Prometheus
       đánh giá alert rule
              ↓
         Alertmanager
   group / route / silence
              ↓
      Email / Webhook / Chat
Prometheus quyết định một alert có đang pending hay firing dựa trên biểu thức PromQL. Alertmanager không tự đi scrape metric.
Điểm này rất quan trọng: nếu bạn muốn sửa điều kiện CPU > 90%, hãy sửa alert rule ở Prometheus; nếu muốn cảnh báo critical đi tới nhóm trực vận hành còn warning chỉ gửi email, hãy sửa route ở Alertmanager.
Khi nào Alertmanager đáng dùng?
Ngay cả một VPS cũng có thể dùng Alertmanager, nhưng giá trị tăng rõ khi bạn có:
- nhiều VPS;
- nhiều service;
- nhiều mức độ severity;
- cần tránh gửi 20 cảnh báo cho cùng một sự cố;
- cần silence trong maintenance window;
- muốn route alert theo team.
Nếu bạn chỉ cần biết website down và muốn một giao diện đơn giản, Uptime Kuma có thể phù hợp hơn. Xem bài Cài Uptime Kuma trên VPS Ubuntu.
Chuẩn bị
Giả sử bạn đã có:
- Ubuntu Server đang được hỗ trợ;
- Prometheus đang chạy;
- quyền
sudo; - ít nhất một target Node Exporter;
- một đường nhận thông báo như webhook hoặc email.
Kiểm tra Prometheus:
sudo systemctl status prometheus
Kiểm tra target:
http://127.0.0.1:9090/targets
Nếu Prometheus chưa scrape ổn định, chưa nên cấu hình alerting.
Cài Alertmanager trên Ubuntu
Ubuntu 26.04 LTS có package prometheus-alertmanager trong repository Universe. Có thể cài bằng APT:
sudo apt update
sudo apt install -y prometheus-alertmanager
Kiểm tra service:
sudo systemctl status prometheus-alertmanager
Kiểm tra port listen:
sudo ss -tulnp | grep 9093
Alertmanager thường dùng port 9093.
Không nên mở 9093 ra toàn Internet chỉ để xem UI. Nếu cần truy cập từ xa, ưu tiên SSH tunnel, private network, Tailscale hoặc reverse proxy có authentication.
Tìm file cấu hình Alertmanager
Tùy package, đường dẫn thường nằm dưới /etc/prometheus/.
Kiểm tra command line service:
systemctl cat prometheus-alertmanager
Bạn cần xác định chính xác giá trị --config.file thay vì đoán.
Sao lưu trước khi sửa:
sudo cp /etc/prometheus/alertmanager.yml /etc/prometheus/alertmanager.yml.bak
Cấu hình Alertmanager tối thiểu
Ví dụ đơn giản:
global:
  resolve_timeout: 5m

route:
  receiver: default-webhook
  group_by: ['alertname', 'instance']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h

receivers:
  - name: default-webhook
    webhook_configs:
      - url: 'https://example.internal/alerts'
        send_resolved: true
Ý nghĩa:
group_by: alert nào có cùng các label này có thể được gom nhóm;group_wait: chờ một khoảng trước notification đầu tiên để gom thêm alert liên quan;group_interval: khoảng tối thiểu trước khi gửi thêm notification cho cùng group;repeat_interval: nếu alert vẫn còn firing, sau bao lâu nhắc lại;send_resolved: gửi thông báo khi sự cố đã hết.
Không nên copy nguyên các khoảng thời gian trên cho mọi hệ thống. Web thương mại và batch server có nhịp cảnh báo khác nhau.
Validate cấu hình bằng amtool
Trước khi restart:
amtool check-config /etc/prometheus/alertmanager.yml
Prometheus project hiện cũng khuyến nghị dùng amtool để kiểm tra cấu hình và khả năng tương thích với parser UTF-8 mới của Alertmanager.
Nếu hợp lệ, reload/restart theo service package:
sudo systemctl restart prometheus-alertmanager
Sau đó:
sudo journalctl -u prometheus-alertmanager -n 100 --no-pager
Kết nối Prometheus với Alertmanager
Mở file Prometheus, thường là:
/etc/prometheus/prometheus.yml
Thêm hoặc kiểm tra block:
alerting:
  alertmanagers:
    - static_configs:
        - targets:
            - '127.0.0.1:9093'
Nếu Alertmanager nằm ở VPS khác, dùng private IP/hostname phù hợp.
Không public port chỉ để hai máy nói chuyện nếu bạn đã có private network hoặc Tailscale.
Validate Prometheus:
promtool check config /etc/prometheus/prometheus.yml
Sau đó reload/restart:
sudo systemctl reload prometheus
Nếu package không hỗ trợ reload qua systemd như bạn mong đợi, dùng restart có kiểm soát.
Tạo alert rule đầu tiên
Tạo file:
sudo nano /etc/prometheus/alerts.yml
Ví dụ cảnh báo instance down:
groups:
  - name: vps-basic
    rules:
      - alert: InstanceDown
        expr: up == 0
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Instance {{ $labels.instance }} không scrape được"
          description: "Prometheus không scrape được target trong hơn 2 phút."
Trong prometheus.yml, khai báo:
rule_files:
  - /etc/prometheus/alerts.yml
Validate:
promtool check rules /etc/prometheus/alerts.yml
promtool check config /etc/prometheus/prometheus.yml
Prometheus hỗ trợ for: để một điều kiện phải tồn tại đủ lâu trước khi chuyển sang trạng thái firing. Điều này giúp tránh alert do spike vài giây.
Rule cảnh báo disk gần đầy
Ví dụ:
- alert: FilesystemAlmostFull
  expr: |
    100 * (
      1 - node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}
      / node_filesystem_size_bytes{fstype!~"tmpfs|overlay"}
    ) > 90
  for: 15m
  labels:
    severity: warning
  annotations:
    summary: "Disk usage cao trên {{ $labels.instance }}"
Đừng alert mọi mount pseudo-filesystem. Hãy lọc theo môi trường thực tế.
Nếu disk đã đầy, xem bài VPS Ubuntu bị đầy ổ đĩa để xử lý nguyên nhân.
Rule cảnh báo CPU cao
Ví dụ:
- alert: HighCPUUsage
  expr: |
    100 - (
      avg by (instance) (
        rate(node_cpu_seconds_total{mode="idle"}[5m])
      ) * 100
    ) > 90
  for: 10m
  labels:
    severity: warning
  annotations:
    summary: "CPU cao trên {{ $labels.instance }}"
Điều kiện for: 10m giúp tránh cảnh báo chỉ vì CPU spike khi build, backup hoặc cron job.
Nếu CPU cao kéo dài, bài VPS Ubuntu CPU cao có quy trình tìm process bằng top, pidstat và mpstat.
Thiết kế severity
Một mô hình đơn giản:
info      → chỉ ghi nhận/dashboard
warning   → cần kiểm tra trong giờ làm việc
critical  → cần phản hồi nhanh
Không nên để mọi alert là critical.
Nếu hệ thống gửi 50 alert critical/ngày, đội vận hành sẽ nhanh chóng bỏ qua chúng. Đây là hiện tượng alert fatigue.
Route theo severity
Ví dụ:
route:
  receiver: ops-email
  group_by: ['alertname', 'instance']
  routes:
    - matchers:
        - severity="critical"
      receiver: critical-webhook

    - matchers:
        - severity="warning"
      receiver: ops-email
Receiver critical-webhook có thể trỏ vào webhook nội bộ hoặc hệ thống chat/incident management của bạn.
Không đặt token API trực tiếp trong Git repository nếu file cấu hình được version-control.
Grouping giúp chống spam như thế nào?
Giả sử một switch/network path lỗi khiến 20 VPS cùng mất scrape.
Nếu không group, bạn có thể nhận 20 notification gần như đồng thời.
Với:
group_by: ['alertname']
Alertmanager có thể gom chúng thành một group theo alert name.
Nhưng group quá rộng cũng có nhược điểm: một notification có thể chứa quá nhiều instance và khó đọc.
Hãy chọn label phản ánh cách team xử lý sự cố.
Inhibition: ẩn alert phụ khi nguyên nhân gốc đã rõ
Ví dụ: nếu một VPS hoàn toàn down, bạn không cần cùng lúc nhận:
- InstanceDown;
- CPUDataMissing;
- DiskDataMissing;
- NodeExporterMissing.
Có thể dùng inhibition để alert critical về instance down suppress một số warning cùng instance.
Ví dụ khái niệm:
inhibit_rules:
  - source_matchers:
      - alertname="InstanceDown"
    target_matchers:
      - severity="warning"
    equal:
      - instance
Inhibition làm notification gọn hơn nhưng phải test kỹ để không che mất alert độc lập quan trọng.
Silence dùng khi bảo trì
Khi chuẩn bị reboot, migrate hoặc bảo trì VPS, tạo silence theo label thay vì tắt toàn bộ monitoring.
Ví dụ silence:
instance="10.10.0.12:9100"
với thời hạn rõ ràng.
Đừng tạo silence không có thời gian kết thúc rồi quên bật lại cảnh báo.
Cách test alert mà không phá production
Bạn có thể tạo một rule test an toàn:
- alert: AlertmanagerPipelineTest
  expr: vector(1)
  for: 1m
  labels:
    severity: warning
  annotations:
    summary: "Test pipeline alerting"
Sau khi nhận được notification và resolved event, xóa rule test.
Không nên tắt service production chỉ để kiểm tra Alertmanager.
Kiểm tra Alertmanager UI an toàn
Nếu Alertmanager chỉ listen local/private network, dùng SSH tunnel:
ssh -L 9093:127.0.0.1:9093 admin@monitoring-vps
Sau đó mở:
http://127.0.0.1:9093
Bạn có thể kiểm tra active alerts và silences mà không mở port public.
Bảo vệ secret receiver
Nếu receiver dùng token/webhook URL bí mật:
- giới hạn permission file;
- không commit secret vào Git;
- dùng secret manager nếu hạ tầng hỗ trợ;
- rotate token định kỳ;
- không paste full URL vào ticket/chat công khai.
Ví dụ permission:
sudo chown root:prometheus /etc/prometheus/alertmanager.yml
sudo chmod 640 /etc/prometheus/alertmanager.yml
Tên group/user thực tế phụ thuộc package của bạn. Kiểm tra bằng systemctl cat và ps trước khi đổi owner.
Alertmanager không nên public 9093
Alertmanager có hỗ trợ cấu hình TLS/basic auth qua web config, nhưng cách đơn giản và an toàn hơn với VPS nhỏ thường là:
- bind private/local;
- firewall đúng source;
- VPN/Tailscale;
- reverse proxy có authentication.
Kiểm tra:
sudo ss -tulnp | grep 9093
sudo ufw status numbered
Theo dõi chính Alertmanager
Monitoring system cũng có thể lỗi.
Bạn nên kiểm tra:
- Alertmanager process còn chạy;
- Prometheus có gửi alert tới Alertmanager không;
- receiver có lỗi delivery không;
- disk còn đủ;
- clock/NTP đúng;
- notification backlog bất thường.
Một cảnh báo quan trọng nhưng không tới người trực = hệ thống alerting thất bại dù dashboard vẫn đẹp.
Quy trình triển khai production gợi ý
- cài Alertmanager;
- chỉ bind local/private network;
- cấu hình một receiver test;
- validate bằng
amtool; - kết nối Prometheus;
- tạo 2–3 rule quan trọng nhất;
- test firing/resolved;
- thêm severity;
- thêm grouping;
- chỉ sau đó mới thêm nhiều rule.
Đừng bắt đầu với 100 alert rule tải từ Internet.
Sai lầm thường gặp
Alert mọi CPU spike
CPU 90% trong 20 giây có thể bình thường. Dùng for: và time window hợp lý.
Mọi alert đều critical
Bạn sẽ tạo alert fatigue.
Không group alert
Một lỗi upstream có thể biến thành hàng chục notification.
Không gửi resolved notification
Người trực biết sự cố bắt đầu nhưng không biết đã tự phục hồi hay chưa.
Public Alertmanager UI
Đây là bề mặt quản trị không nên phơi ra Internet nếu không cần.
Checklist
- Prometheus đang scrape target ổn định.
- Alertmanager cài và chạy.
- Port 9093 không public không cần thiết.
-
amtool check-configpass. -
promtool check rulespass. - Prometheus trỏ đúng Alertmanager.
- Có rule
InstanceDown. - Có severity rõ ràng.
- Có grouping/repeat interval hợp lý.
- Test notification firing và resolved.
- Có quy trình silence cho maintenance.
FAQ
Alertmanager có thay Grafana Alerting không?
Không hoàn toàn. Grafana có hệ thống alerting riêng. Nếu bạn đã dùng Prometheus rule và muốn route/deduplicate theo kiến trúc Prometheus-native, Alertmanager là thành phần phù hợp. Chọn một mô hình rõ ràng để tránh gửi alert trùng.
Alertmanager có tự đọc metric không?
Không. Prometheus đánh giá alert rule và gửi alert sang Alertmanager.
Có cần Alertmanager khi chỉ có một VPS?
Không bắt buộc, nhưng vẫn hữu ích nếu bạn muốn grouping, silence, routing và resolved notification rõ ràng.
Nên dùng warning và critical như thế nào?
warning thường là tình trạng cần theo dõi/xử lý sớm; critical là lỗi cần phản ứng nhanh. Định nghĩa cụ thể nên dựa vào SLO và tác động người dùng.
Có nên alert CPU trên 80% không?
Không nên dùng một ngưỡng cố định cho mọi workload. Hãy kết hợp thời gian duy trì, baseline và latency/service impact.
Kết luận
Alertmanager biến Prometheus từ một hệ thống “biết có sự cố” thành một pipeline cảnh báo có tổ chức. Giá trị lớn nhất không phải gửi notification thật nhanh, mà là gửi đúng alert, đúng mức độ, đúng người và không spam.
Hãy bắt đầu với vài rule có hành động rõ ràng như instance down, disk gần đầy và CPU cao kéo dài; sau đó mới mở rộng dựa trên sự cố thật đã gặp.
Nếu bạn đang xây dựng monitoring cho nhiều VPS hoặc ứng dụng production, có thể tham khảo các dịch vụ VPS tại HUONG CLOUD và lựa chọn tài nguyên dựa trên metric thực tế thay vì ước đoán.
Nguồn tham khảo
- Prometheus — Alertmanager configuration: https://prometheus.io/docs/alerting/latest/configuration/
- Prometheus — Alerting rules: https://prometheus.io/docs/prometheus/latest/configuration/alerting_rules/
- Prometheus — Prometheus configuration / Alertmanager targets: https://prometheus.io/docs/prometheus/latest/configuration/configuration/
- Ubuntu Packages — prometheus-alertmanager: https://packages.ubuntu.com/prometheus-alertmanager
Kết luận
Nếu chưa chắc cấu hình hoặc loại dịch vụ nào phù hợp, hãy gửi nhu cầu thực tế để đội ngũ hỗ trợ tư vấn trước khi mua.
Chưa biết nên chọn gói nào?
Xem bảng giá VPS hoặc liên hệ đội ngũ hỗ trợ để chọn cấu hình phù hợp.
Xem bảng giá VPS →