
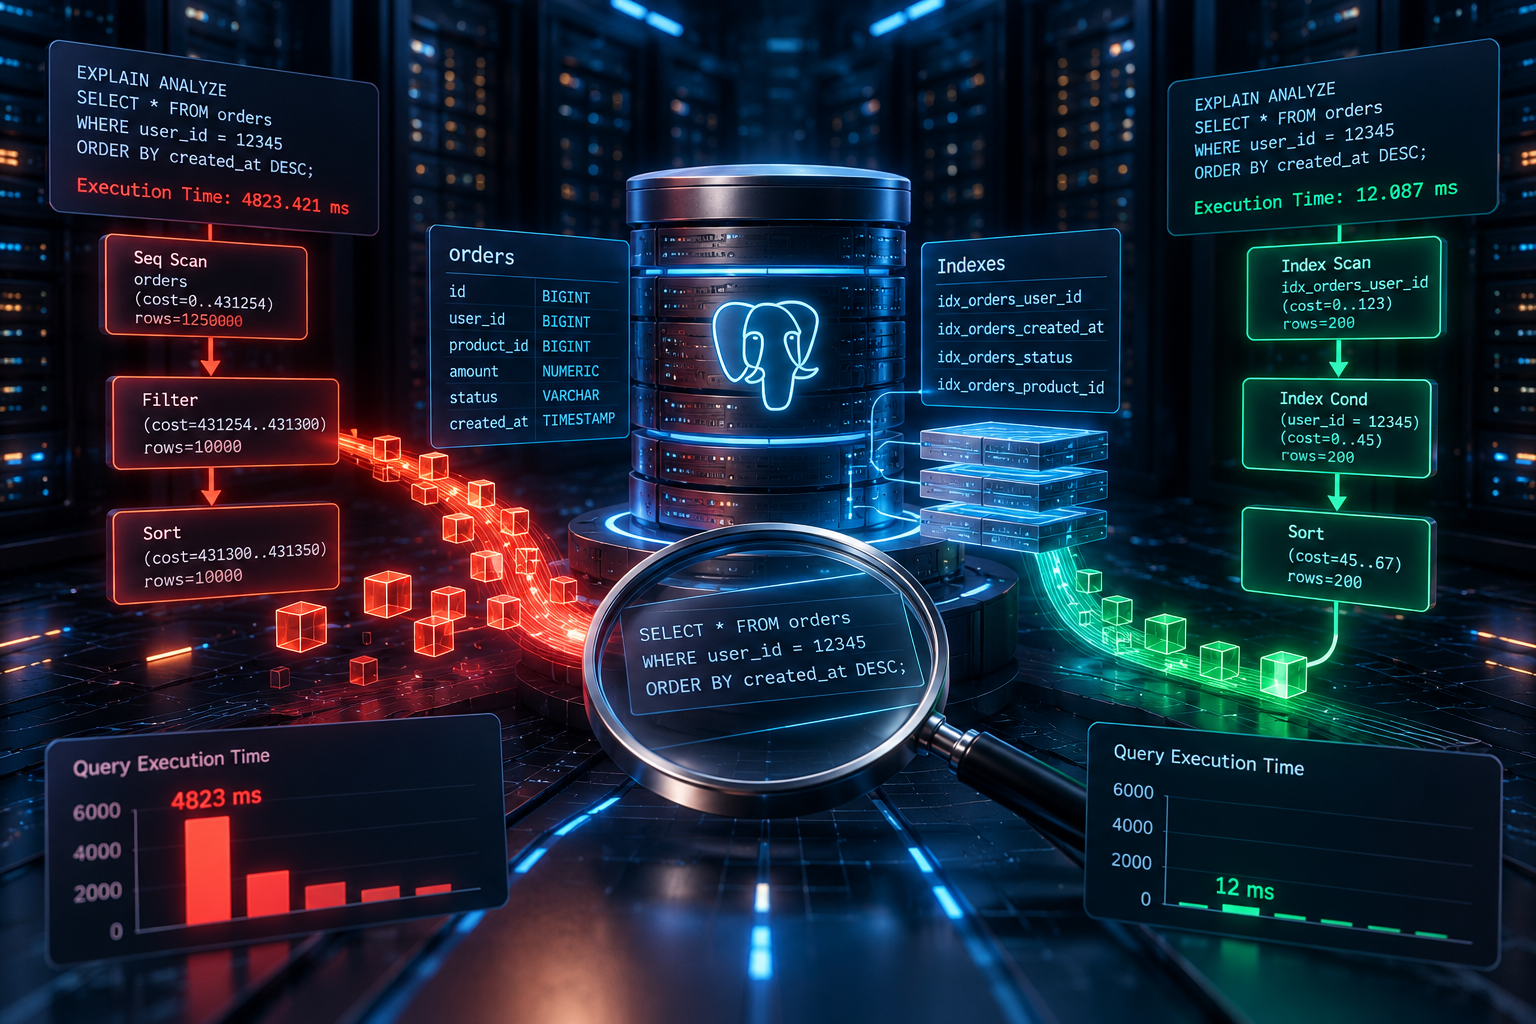
PostgreSQL chậm trên VPS không nhất thiết do thiếu CPU hay RAM. Một truy vấn quét quá nhiều dòng, statistics cũ, index không phù hợp hoặc join/sort tốn kém đều có thể làm latency tăng. Bài viết này hướng dẫn bật `pg_stat_statements` để tìm nhóm query tiêu tốn thời gian, dùng `EXPLAIN`/`EXPLAIN ANALYZE` để đọc execution plan, kiểm tra statistics bằng `ANALYZE` và chỉ tạo index khi workload thực sự chứng minh cần thiết.
Khi ứng dụng dùng PostgreSQL bắt đầu chậm, cách xử lý hiệu quả nhất không phải là tăng shared_buffers hoặc nâng VPS ngay lập tức. Bạn cần biết query nào đang tốn tài nguyên, vì sao planner chọn plan đó và dữ liệu thực tế có khớp ước lượng hay không.
PostgreSQL có sẵn nhiều công cụ rất mạnh cho việc này:
pg_stat_statements— thống kê query đã chạy;EXPLAIN— xem execution plan;EXPLAIN ANALYZE— chạy query và đo thời gian thực tế từng node;ANALYZE— cập nhật statistics để planner ước lượng tốt hơn.
Nếu bạn mới cài PostgreSQL, có thể xem bài Cài PostgreSQL trên VPS Ubuntu trước. Bài này tập trung vào tuning dựa trên số liệu.
Bước 1: xác nhận bottleneck có nằm ở PostgreSQL không
Trên VPS, kiểm tra nhanh:
uptime
free -h
df -h
iostat -xz 1 5
Nếu chưa có iostat:
sudo apt update
sudo apt install -y sysstat
Các dấu hiệu đáng chú ý:
- CPU cao kéo dài;
%iowaitcao;- swap hoạt động nhiều;
- disk gần đầy;
- PostgreSQL process chiếm phần lớn CPU/I/O.
Nếu VPS đang đầy ổ đĩa, xử lý storage trước theo bài VPS Ubuntu bị đầy ổ đĩa.
pg_stat_statements dùng để làm gì?
Theo tài liệu PostgreSQL, module pg_stat_statements theo dõi statistics về planning và execution của SQL statement đã chạy trên server.
Nó nhóm các query có cấu trúc giống nhau và chuẩn hóa literal, giúp bạn trả lời các câu hỏi như:
- query nào tốn tổng thời gian nhiều nhất;
- query nào chạy nhiều nhất;
- query nào trung bình chậm nhất;
- query nào đọc nhiều block;
- query nào có execution time biến động lớn.
Đây là cách tốt hơn việc chỉ nhìn một query “chậm nhất” tại một thời điểm.
Bật pg_stat_statements
Module cần được preload vì sử dụng shared memory.
Kiểm tra file cấu hình PostgreSQL đang dùng:
SHOW config_file;
Trong postgresql.conf, thêm hoặc chỉnh:
shared_preload_libraries = 'pg_stat_statements'
Nếu đã có extension khác:
shared_preload_libraries = 'pg_stat_statements,other_extension'
Sau thay đổi này cần restart PostgreSQL:
sudo systemctl restart postgresql
Sau đó, trong database cần quan sát:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
Kiểm tra:
SELECT * FROM pg_stat_statements LIMIT 1;
PostgreSQL Docs lưu ý module phải có pg_stat_statements trong shared_preload_libraries, và query identifier phải được bật để module hoạt động.
Tìm query tốn tổng thời gian nhiều nhất
Ví dụ:
SELECT
    calls,
    total_exec_time,
    mean_exec_time,
    rows,
    query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 20;
total_exec_time rất hữu ích vì một query chỉ mất 50 ms nhưng chạy hàng triệu lần có thể gây tải lớn hơn query 5 giây chỉ chạy một lần/ngày.
Tìm query trung bình chậm
SELECT
    calls,
    mean_exec_time,
    total_exec_time,
    query
FROM pg_stat_statements
WHERE calls > 20
ORDER BY mean_exec_time DESC
LIMIT 20;
Điều kiện calls > 20 giúp bỏ bớt các query hiếm gặp khi bạn muốn tìm pattern ổn định.
Không có ngưỡng cố định đúng cho mọi workload.
Reset statistics khi benchmark
Nếu bạn vừa deploy index hoặc sửa query và muốn đo lại một giai đoạn mới:
SELECT pg_stat_statements_reset();
Cảnh báo: reset sẽ xóa statistics tích lũy của module. Đừng reset trên production nếu team đang cần dữ liệu lịch sử để điều tra sự cố.
Dùng EXPLAIN trước
Giả sử query:
SELECT id, user_id, total, created_at
FROM orders
WHERE user_id = 12345
ORDER BY created_at DESC
LIMIT 50;
Chạy:
EXPLAIN
SELECT id, user_id, total, created_at
FROM orders
WHERE user_id = 12345
ORDER BY created_at DESC
LIMIT 50;
Bạn có thể thấy các node như:
- Seq Scan;
- Index Scan;
- Bitmap Heap Scan;
- Nested Loop;
- Hash Join;
- Sort;
- Aggregate.
Execution plan cho biết PostgreSQL dự định đọc bảng/index theo cách nào.
EXPLAIN ANALYZE khác gì?
EXPLAIN ANALYZE
SELECT id, user_id, total, created_at
FROM orders
WHERE user_id = 12345
ORDER BY created_at DESC
LIMIT 50;
Khác với EXPLAIN, EXPLAIN ANALYZE thực sự chạy query và ghi nhận thời gian thực tế.
PostgreSQL Docs cũng lưu ý việc profiling có overhead, nên runtime của EXPLAIN ANALYZE có thể khác query bình thường.
Đặc biệt quan trọng: với UPDATE, DELETE, INSERT hoặc query có side effect, EXPLAIN ANALYZE sẽ thực hiện thay đổi thật.
Trên production, hãy cực kỳ cẩn thận.
An toàn hơn với query ghi dữ liệu
Nếu cần phân tích query ghi, có thể chạy trong transaction và rollback nếu phù hợp:
BEGIN;

EXPLAIN ANALYZE
UPDATE orders
SET status = 'processed'
WHERE id = 123;

ROLLBACK;
Nhưng transaction vẫn có thể tạo lock, WAL hoặc tác động khác trong thời gian chạy. Tốt nhất vẫn là test trên staging hoặc bản sao dữ liệu khi query nặng.
Đọc estimated rows và actual rows
Một trong các tín hiệu quan trọng nhất là sự lệch nhau giữa:
- rows planner ước lượng;
- rows thực tế trong
EXPLAIN ANALYZE.
Nếu planner nghĩ chỉ có 100 rows nhưng thực tế có 1.000.000 rows, nó có thể chọn join/index strategy không phù hợp.
Nguyên nhân thường gặp:
- statistics cũ;
- data distribution lệch;
- correlation giữa nhiều column;
- statistics target chưa đủ cho column đặc thù.
Chạy ANALYZE
PostgreSQL dùng statistics để planner ước lượng selectivity và cost.
Chạy cho bảng cụ thể:
ANALYZE orders;
Hoặc verbose:
ANALYZE VERBOSE orders;
Theo PostgreSQL Docs, ANALYZE thu thập statistics về nội dung bảng và lưu vào system catalog để planner chọn plan hiệu quả hơn.
Autovacuum thường tự chạy analyze, nhưng sau bulk import hoặc thay đổi dữ liệu lớn, bạn có thể cần manual ANALYZE sớm hơn.
Kiểm tra index trước khi tạo mới
Xem index:
SELECT
    indexname,
    indexdef
FROM pg_indexes
WHERE tablename = 'orders';
Nếu query thường dùng:
WHERE user_id = ?
ORDER BY created_at DESC
LIMIT 50
một index có thể cân nhắc:
CREATE INDEX CONCURRENTLY idx_orders_user_created
ON orders (user_id, created_at DESC);
CONCURRENTLY giảm thời gian block write so với tạo index thông thường, nhưng mất lâu hơn và có các giới hạn riêng.
Không copy index này cho mọi schema. Hãy dựa trên query thật và execution plan.
Vì sao không tạo index cho mọi column?
Index có chi phí:
- tốn disk;
- tăng WAL;
- làm INSERT/UPDATE/DELETE chậm hơn;
- tăng vacuum/maintenance work;
- cache phải chứa thêm page index.
PostgreSQL Docs nhấn mạnh việc quyết định index cần thử nghiệm dựa trên workload thật; không có quy tắc “column lọc là phải index” đúng cho mọi trường hợp.
Seq Scan không phải lúc nào cũng xấu
Thấy Seq Scan không có nghĩa query lỗi.
Nếu bảng nhỏ hoặc query cần đọc phần lớn rows, sequential scan có thể nhanh hơn đi qua index rồi random-read heap pages.
Đừng cố tắt:
enable_seqscan = off
như một “tối ưu” production lâu dài.
Nếu planner chọn Seq Scan, hãy hỏi:
- bảng có nhỏ không;
- điều kiện có match nhiều rows không;
- statistics có đúng không;
- index có phù hợp query không.
Kiểm tra sort và temp file
Query ORDER BY, GROUP BY, hash hoặc join có thể spill ra disk khi work memory không đủ.
Đừng tăng work_mem quá lớn ở mức global chỉ vì một query.
work_mem có thể được dùng cho nhiều operation trong mỗi query/session, nên mức quá cao với nhiều concurrent query có thể tiêu thụ RAM rất nhanh.
Nếu cần, có thể set theo session để test:
SET work_mem = '64MB';
Sau đó đo lại plan/runtime.
Query nhiều lần vs query cực chậm
Hai trường hợp cần ưu tiên khác nhau:
Query A
- 20 ms/call;
- 2 triệu calls/ngày.
Query B
- 8 giây/call;
- 5 calls/ngày.
A có thể tiêu thụ tổng CPU lớn hơn nhiều. pg_stat_statements giúp nhìn cả tổng thời gian và mean time thay vì chỉ “query nào lâu nhất một lần”.
Connection quá nhiều cũng làm database chậm
Kiểm tra:
SELECT count(*) FROM pg_stat_activity;
Theo state:
SELECT state, count(*)
FROM pg_stat_activity
GROUP BY state;
Ứng dụng mở hàng trăm connection không cần thiết có thể tăng memory/process overhead.
Connection pool như PgBouncer có thể hữu ích trong workload nhiều client, nhưng không giải quyết query chậm do schema/index.
Long transaction và lock
Tìm transaction chạy lâu:
SELECT
    pid,
    now() - xact_start AS xact_age,
    state,
    query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
Transaction mở lâu có thể:
- giữ lock;
- cản VACUUM dọn tuple cũ;
- làm table/index bloat tăng;
- khiến query khác chờ.
Không pg_terminate_backend() tùy tiện trên production. Hãy hiểu transaction đó thuộc ứng dụng nào trước.
Quy trình tối ưu thực tế
Một workflow tốt:
- xem host metric CPU/RAM/I/O;
- lấy top query từ
pg_stat_statements; - chọn query có impact cao;
- chạy
EXPLAIN; - nếu an toàn, chạy
EXPLAIN ANALYZEtrên staging/production có kiểm soát; - so sánh estimated vs actual rows;
- cập nhật
ANALYZEnếu statistics cũ; - sửa query/index;
- đo lại;
- theo dõi vài giờ/ngày sau thay đổi.
Ví dụ tối ưu query đơn giản
Ban đầu:
SELECT *
FROM orders
WHERE user_id = 12345
ORDER BY created_at DESC;
Các vấn đề tiềm năng:
- lấy mọi column;
- không
LIMIT; - có thể thiếu index phù hợp.
Nếu UI chỉ cần 20 order gần nhất:
SELECT id, status, total, created_at
FROM orders
WHERE user_id = 12345
ORDER BY created_at DESC
LIMIT 20;
Sau đó mới cân nhắc index:
CREATE INDEX CONCURRENTLY idx_orders_user_created
ON orders(user_id, created_at DESC);
Rồi đo lại bằng EXPLAIN ANALYZE hoặc statistics thực tế.
Kết hợp monitoring
PostgreSQL query metric hữu ích hơn khi đặt cạnh host metric.
Ví dụ:
- CPU tăng 90%;
pg_stat_statementscho thấy query A chiếm 65% total execution time;EXPLAIN ANALYZEcho thấy Seq Scan hàng triệu rows;- tạo index phù hợp;
- CPU giảm và latency p95 giảm.
Nếu chưa có monitoring, xem bài Giám sát VPS bằng Prometheus và Grafana.
Sai lầm thường gặp
Tăng shared_buffers trước khi đo query
Memory tuning không sửa được query thiếu index hoặc join sai.
Thấy Seq Scan là ép dùng index
Planner có thể đúng khi table nhỏ hoặc selectivity thấp.
Chạy EXPLAIN ANALYZE DELETE ... trên production mà quên nó chạy thật
Đây là lỗi nguy hiểm. ANALYZE trong EXPLAIN ANALYZE có nghĩa là thực thi để đo, không phải chỉ phân tích plan.
Tạo quá nhiều index
Write workload và disk sẽ chịu chi phí.
Reset pg_stat_statements quá thường xuyên
Bạn mất dữ liệu tổng hợp có giá trị về workload dài hạn.
Checklist xử lý PostgreSQL chậm
- Kiểm tra CPU/RAM/I/O của VPS.
- Bật
pg_stat_statements. - Tìm top query theo total time và mean time.
- Xem
EXPLAIN. - Dùng
EXPLAIN ANALYZEcó kiểm soát. - So estimated rows với actual rows.
- Chạy
ANALYZEkhi statistics có thể cũ. - Chỉ tạo index dựa trên workload thật.
- Kiểm tra long transaction/lock.
- Đo lại sau mỗi thay đổi.
FAQ
pg_stat_statements có làm PostgreSQL chậm nhiều không?
Nó có overhead vì phải thu statistics, nhưng thường được dùng rộng rãi để quan sát workload. Hãy đo trên hệ thống của bạn và cấu hình retention/max phù hợp.
EXPLAIN ANALYZE có chạy query thật không?
Có. Nó thực thi statement để thu runtime statistics. Với query ghi dữ liệu, đây là điểm phải đặc biệt cẩn thận.
Có nên tạo index khi thấy Seq Scan không?
Không nhất thiết. Planner có thể chọn Seq Scan vì đó là phương án rẻ hơn. Hãy xem selectivity, table size và actual runtime.
ANALYZE có khóa bảng lâu không?
Thông thường ANALYZE được thiết kế để thu statistics với tác động vận hành tương đối thấp, nhưng vẫn có thể tương tác với lock trong một số tình huống. Production lớn nên chạy có giám sát.
PostgreSQL chậm có nên tăng RAM trước không?
Chỉ khi metric cho thấy memory/cache thực sự là bottleneck. Query, index, statistics và I/O nên được kiểm tra trước.
Kết luận
Tối ưu PostgreSQL trên VPS hiệu quả nhất khi bắt đầu từ workload thật. pg_stat_statements giúp bạn biết query nào đáng ưu tiên, EXPLAIN ANALYZE cho thấy planner và runtime thực tế, còn ANALYZE giữ statistics đủ mới để planner ra quyết định tốt.
Đừng tối ưu bằng cảm giác hoặc copy một bộ postgresql.conf từ Internet. Đo trước, thay đổi một thứ, rồi đo lại.
Nếu sau khi tối ưu query, index và connection mà workload hợp lệ vẫn thường xuyên chạm giới hạn CPU/RAM/I/O, bạn có thể tham khảo các gói VPS tại HUONG CLOUD và lựa chọn tài nguyên dựa trên số liệu thực tế.
Nguồn tham khảo
- PostgreSQL Docs — pg_stat_statements: https://www.postgresql.org/docs/current/pgstatstatements.html
- PostgreSQL Docs — EXPLAIN: https://www.postgresql.org/docs/current/sql-explain.html
- PostgreSQL Docs — Using EXPLAIN: https://www.postgresql.org/docs/current/using-explain.html
- PostgreSQL Docs — ANALYZE: https://www.postgresql.org/docs/current/sql-analyze.html
Kết luận
Nếu chưa chắc cấu hình hoặc loại dịch vụ nào phù hợp, hãy gửi nhu cầu thực tế để đội ngũ hỗ trợ tư vấn trước khi mua.
Chưa biết nên chọn gói nào?
Xem bảng giá VPS hoặc liên hệ đội ngũ hỗ trợ để chọn cấu hình phù hợp.
Xem bảng giá VPS →